Лучшие способы отлаживать код, а не гадать
«Добавлю ещё один print и посмотрю» — рабочий метод, но только для самых простых случаев. Когда баг не воспроизводится стабильно или прячется в глубине чужого кода, гадание методом случайных правок начинает отнимать часы. Вот шесть способов отлаживать осознанно, независимо от языка программирования.
Разница между отладкой и гаданием
Гадание — это менять код и смотреть, стало ли лучше, без ясной гипотезы, почему именно это должно сработать. Иногда это случайно решает проблему, но не даёт понимания, почему она вообще возникла — а значит, похожий баг с высокой вероятностью появится снова в другом месте.
Осознанная отладка — это цикл: сформулировать гипотезу, проверить её конкретным способом, сделать вывод, перейти к следующей гипотезе. Звучит медленнее, чем «поменять и посмотреть», но на практике почти всегда быстрее — особенно на нетривиальных багах, где случайные правки могут идти часами без результата.
Ниже — шесть способов, которые работают независимо от языка и стека: применимы и в бэкенде, и во фронтенде, и в мобильной разработке.
Топ 6 способов отлаживать код
Сначала добейтесь стабильного воспроизведения
баг, который не воспроизводится по требованию, почти невозможно исправить осознанно
Прежде чем менять хоть одну строчку кода, стоит найти точную последовательность действий, которая надёжно вызывает проблему. Без этого невозможно понять, помогло ли исправление на самом деле, или баг просто не проявился в этот конкретный раз.
Нестабильно воспроизводимый баг — это отдельная, более сложная категория, и для неё сначала стоит найти условия, при которых он проявляется чаще: конкретные данные, порядок действий, состояние системы. Только после этого имеет смысл переходить к следующим способам из списка.
Потраченное на стабильное воспроизведение время почти всегда окупается: становится понятно не только как исправить баг, но и как в дальнейшем проверить, что он действительно исправлен, а не просто временно спрятался.
- Даёт объективный критерий, что баг действительно исправлен
- Экономит время на следующих этапах отладки
- Само по себе часто проясняет часть причины проблемы
- Иногда занимает больше времени, чем кажется на старте
- Не всегда возможно воспроизвести проблему вне продакшен-окружения
- Требует терпения, когда хочется сразу перейти к исправлению
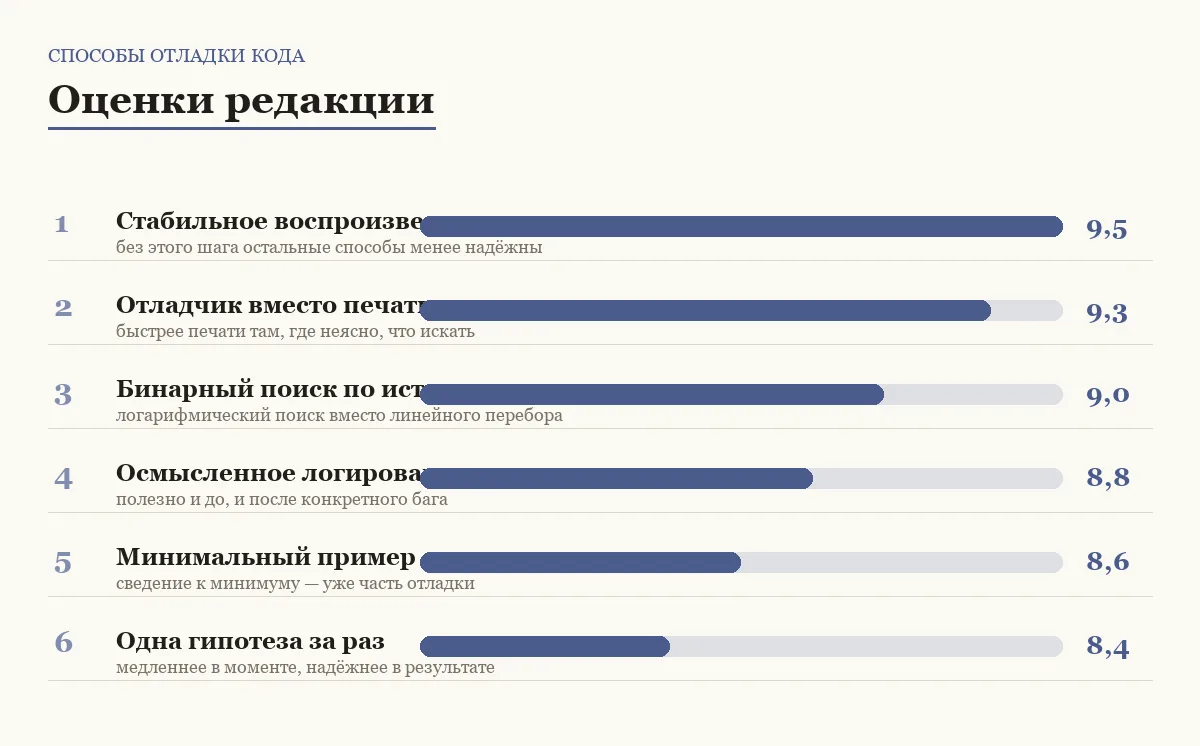
без этого шага остальные способы менее надёжны · оценка 9,5
Используйте отладчик вместо печати вслепую
точка останова показывает больше, чем десяток случайно расставленных выводов в лог
Вывод значений переменных через печать в консоль — рабочий способ для совсем простых случаев, но он требует заранее угадать, что именно нужно вывести. Отладчик с точками останова позволяет остановиться в нужном месте и осмотреть вообще любое состояние программы на этот момент, включая то, о необходимости проверки которого вы даже не думали заранее.
Отладчик особенно выигрывает там, где неясно, что вообще искать. Пошаговое выполнение от точки останова показывает реальный порядок вызовов и реальные значения, а не только то единственное значение, которое вы догадались вывести печатью.
Печать в лог по-прежнему полезна — например, там, где отладчик неудобен или недоступен, в асинхронном или распределённом коде. Хороший специалист использует оба способа в зависимости от ситуации, а не выбирает один навсегда.
- Не требует заранее угадывать, что именно смотреть
- Позволяет осмотреть любое состояние программы на конкретный момент
- Экономит время на повторных перезапусках ради проверки новой переменной
- Требует настройки окружения для конкретного проекта
- Неудобен для асинхронного и распределённого кода
- Не всегда доступен в проде или в чужой инфраструктуре
быстрее печати там, где неясно, что искать · оценка 9,3
Бинарный поиск по истории изменений
когда баг появился недавно, история версий сужает поиск быстрее, чем чтение кода
Если известно, что раньше всё работало, а сейчас — нет, есть смысл не искать причину чтением текущего кода, а найти конкретное изменение, после которого баг появился. Разделите диапазон подозрительных изменений пополам, проверьте среднюю точку, и в зависимости от результата продолжайте поиск в одной из половин — так проблема находится за логарифмическое, а не линейное число проверок.
Этот подход давно автоматизирован во многих системах контроля версий и требует только одного: способа быстро и однозначно проверить, воспроизводится баг в конкретной версии кода или нет. Без надёжного способа проверки бинарный поиск не работает, поэтому первый способ из этого списка — стабильное воспроизведение — здесь тоже необходим.
Метод одинаково хорошо работает и без специальных инструментов — например, вручную переключаясь между сохранёнными версиями файла или конфигурациями, если полноценная система контроля версий недоступна.
- Находит момент появления бага за минимальное число проверок
- Не требует понимания устройства кода на этом этапе
- Работает в любом языке и стеке одинаково
- Требует надёжного способа проверить каждую отдельную версию
- Не помогает, если баг был всегда, а не появился недавно
- На больших изменениях между версиями сужает область, но не находит точную строку
логарифмический поиск вместо линейного перебора · оценка 9,0
Осмысленное логирование вместо хаотичных print
структурированный лог полезен и после того, как конкретный баг найден
Разница между хаотичной печатью «здесь», «тут», «значение: x» и осмысленным логированием — в том, что второе остаётся полезным после отладки, а не удаляется сразу после решения проблемы. Уровни важности сообщений, понятный формат и контекст (какой пользователь, какой запрос, какой шаг процесса) превращают лог в инструмент, а не в мусор для одноразового использования.
Хороший лог отвечает на вопрос «что происходило до того, как всё сломалось». Это особенно ценно для проблем, которые сложно воспроизвести по требованию: если баг уже произошёл один раз в проде, качественный лог может оказаться единственным источником информации о том, что именно тогда пошло не так.
Подробный разбор того, как выстроить логирование так, чтобы оно помогало, а не превращалось в шум, — в материале про правила полезного логирования.
- Остаётся полезным после того, как конкретный баг уже найден
- Единственный источник информации для проблем, которые сложно воспроизвести
- Помогает следующему человеку, который столкнётся с похожей проблемой
- Требует продуманности заранее, а не только в момент отладки
- Избыточное логирование создаёт собственный шум и нагрузку
- Чувствительные данные в логах — отдельный риск, который нужно учитывать
полезно и до, и после конкретного бага · оценка 8,8
Сведите баг к минимальному примеру
чем меньше кода воспроизводит проблему, тем быстрее находится причина
Убирайте из воспроизводящего сценария всё, что не влияет на появление бага: лишние модули, неважные данные, побочную логику. Оставшийся минимальный пример почти всегда быстрее анализировать, чем полноценную часть боевой системы со всеми её зависимостями.
Сам процесс сведения к минимуму часто находит причину раньше, чем анализ готового минимального примера. Убирая код кусок за куском и проверяя, сохраняется ли баг, вы попутно локализуете область, в которой он прячется — это не подготовительный этап перед отладкой, а часть самой отладки.
Минимальный пример полезен и за пределами личной отладки: это именно то, что стоит приложить к сообщению об ошибке коллеге или в чужой открытый проект — с ним отвечающему не нужно тратить время на воспроизведение в своём окружении.
- Процесс сведения к минимуму сам по себе локализует причину
- Минимальный пример быстрее анализировать, чем полную систему
- Отлично подходит для сообщений об ошибках коллегам или в открытые проекты
- Требует времени, которое не всегда есть при срочном инциденте
- Не всегда просто изолировать баг от остальной системы
- Иногда проблема пропадает именно при упрощении — это тоже важный сигнал
сведение к минимуму — уже часть отладки · оценка 8,6
Проверяйте одну гипотезу за раз
меняя два предположения одновременно, невозможно понять, какое из них сработало
Соблазн исправить сразу несколько подозрительных мест одновременно понятен — это кажется быстрее. Проблема в том, что если после этого баг исчез, неясно, какое из изменений было действительно необходимым, а какое — лишним или даже создающим новую скрытую проблему.
Одна гипотеза, одна проверка, один явный вывод — и только потом следующая гипотеза. Это медленнее в моменте, но не оставляет после себя случайных изменений «на всякий случай», которые потом будет сложно объяснить при код-ревью или через полгода при следующем баге в этом же месте.
Полезно фиксировать, какие гипотезы уже проверены и с каким результатом — особенно в долгой отладке, когда легко случайно повторно проверить то же самое предположение, забыв, что оно уже отклонено.
- Даёт ясное понимание, какое именно изменение решило проблему
- Не оставляет лишних необъяснимых правок в коде
- Упрощает объяснение исправления при код-ревью
- Медленнее, чем правка нескольких мест сразу
- Требует дисциплины, особенно под давлением срочного инцидента
- Без записи проверенных гипотез легко повторить одну и ту же проверку
медленнее в моменте, надёжнее в результате · оценка 8,4
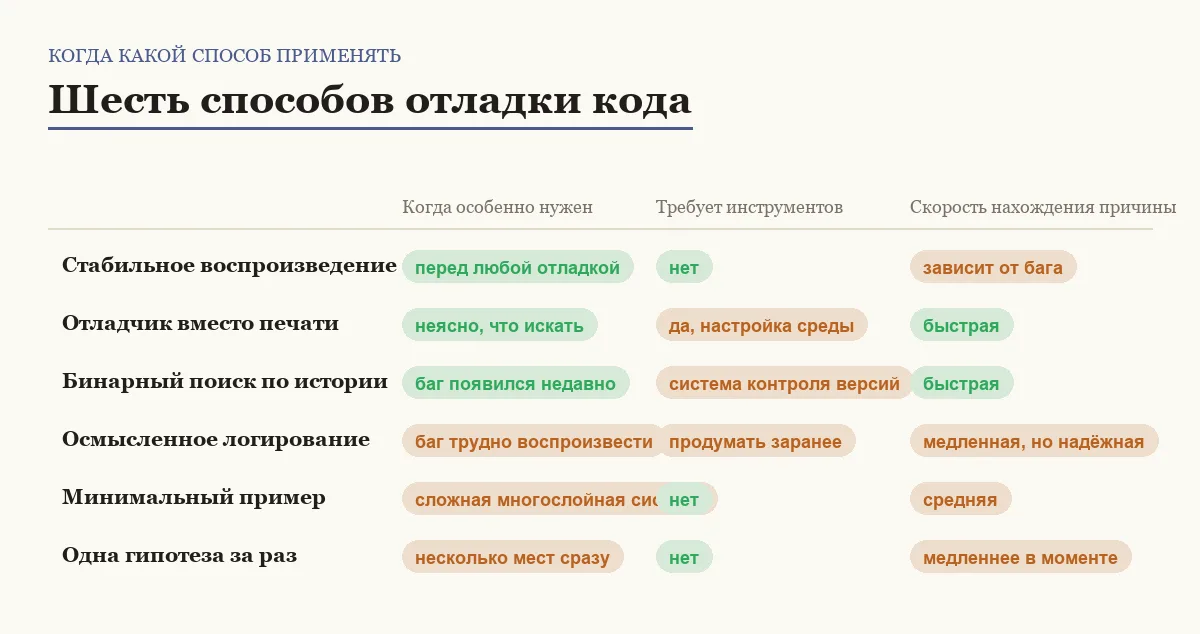
Сравнение по главному
| Способ | Когда особенно нужен | Главный риск без него |
|---|---|---|
| Стабильное воспроизведение | перед любой отладкой | непонятно, помогло ли исправление |
| Отладчик вместо печати | неясно, что вообще искать | долгие циклы правка-перезапуск |
| Бинарный поиск по истории | баг появился недавно | долгий поиск чтением всего кода |
| Осмысленное логирование | баг сложно воспроизвести по требованию | нет данных о случившемся в проде |
| Минимальный пример | сложная многослойная система | анализ лишнего несвязанного кода |
| Одна гипотеза за раз | несколько подозрительных мест сразу | случайные необъяснимые правки |
Как это выглядит в одном цикле отладки
Зафиксируйте воспроизведение, затем выдвиньте одну гипотезу. Не переходите к правкам кода, пока не появится конкретное предположение, почему баг происходит именно так.
Проверьте гипотезу самым быстрым доступным способом. Иногда это отладчик, иногда — временный лог, иногда — бинарный поиск по истории изменений, если баг появился недавно.
Зафиксируйте результат и переходите к следующей гипотезе, если первая не подтвердилась. Записывайте отклонённые гипотезы хотя бы в комментарии или заметку — это экономит время при долгой отладке.
Отладка и тестирование тесно связаны: хорошие тесты не только ловят баги раньше, но и упрощают сведение проблемы к минимальному примеру — подробнее в материале про подходы к тестированию кода.
Частые вопросы
Что делать, если баг не воспроизводится стабильно?
Сначала стоит найти условия, при которых он проявляется чаще — конкретные данные, порядок действий, состояние системы или нагрузку. Осмысленное логирование особенно полезно именно в этом случае: оно собирает информацию о реальных случаях, когда баг всё же произошёл.
Отладчик всегда лучше печати в консоль?
Не всегда — в асинхронном, распределённом или продакшен-коде печать или лог иногда удобнее и доступнее. Отладчик особенно выигрывает, когда неясно, что именно нужно проверить, и нужно осмотреть состояние программы целиком, а не одно заранее угаданное значение.
Сколько времени разумно тратить на сведение бага к минимальному примеру?
Однозначного ориентира нет, но если процесс явно продвигается — код становится проще, а баг сохраняется — это хороший знак продолжать. Если упрощение стопорится надолго без прогресса, возможно, стоит переключиться на отладчик или бинарный поиск по истории изменений.
Работают ли эти способы для багов на фронтенде, а не только на бэкенде?
Да, все шесть способов не привязаны к конкретному языку или части стека. Отладчик браузера, бинарный поиск по истории изменений интерфейса, минимальный воспроизводящий пример на HTML и JavaScript — те же принципы работают одинаково.
Итог
Стабильное воспроизведение — фундамент, без которого остальные способы работают хуже: невозможно понять, помогло ли исправление, если баг и раньше проявлялся не всегда. Отладчик и бинарный поиск по истории изменений — самые быстрые способы найти причину, когда воспроизведение уже есть.
Минимальный пример и проверка одной гипотезы за раз медленнее в моменте, но именно они отличают осознанную отладку от везения — и делают результат объяснимым, а не случайно найденным.
Комментарии
0Будьте первым, кто ответит автору.